딥러닝의 학습

학습 목표
  • 학습이 “전체 손실이 가장 작아지는 가중치를 찾는 과정”임을 설명할 수 있다
  • 순전파로 예측값을 계산하고, 제곱오차·교차 엔트로피로 손실을 직접 계산할 수 있다
  • 전체 손실(MSE, 교차 엔트로피 평균)을 계산할 수 있다
  • Softmax의 역할과 계산 과정을 안다
  • 손실함수 \(J(W)\)가 가중치의 함수임을 이해하고, 좋은 가중치를 \(\operatorname{argmin}\)으로 쓸 수 있다
  • 손실함수를 가중치로 미분·편미분하여 기울기를 구할 수 있다
  • 경사하강법의 갱신을 계산하고, 학습률에 따라 손실이 어떻게 달라지는지 설명할 수 있다

1. 학습이란 무엇인가

앞 장에서 인공신경망의 구조를 만들었다. 노드와 아크를 그리고, 아크마다 가중치가 붙는다는 것까지 정했다. 그런데 그 가중치 값은 누가 정하는가? 이 장의 주제다.

학습 (Learning)

주어진 데이터에 대해 전체 손실이 가장 작아지는 가중치를 찾아 나가는 과정.

  • 데이터: 주어지는 것
  • 가중치: 데이터를 통해 학습하는 것

1장에서 “오차가 가장 작아지는 파라미터를 찾는 과정”이라 한 것과 같은 말이다. 이 장에서는 그 오차를 신경망에 맞게 정확히 정의하고, 찾아 나가는 방법을 배운다.

이 장은 네 가지 질문에 차례로 답한다.

  1. 데이터 한 건이 얼마나 틀렸는지 어떻게 숫자로 만드나 → 손실
  2. 데이터 전체로는 어떻게 합치나 → 전체 손실
  3. 어떤 가중치가 좋은 가중치인가 → 손실함수의 최소화
  4. 그 가중치를 어떻게 찾나 → 미분과 경사하강법. 이 장의 후반은 예제 하나를 잡고 최솟값에 도달할 때까지 한 스텝씩 따라간다

예제 데이터는 다음과 같다.

  • \(x_1\): 참여한 수업의 개수
  • \(x_2\): 기말 프로젝트에 투자한 시간
  • \(y\): 기말 점수 (%) → 실수이므로 회귀 문제
코드
import pandas as pd

score_data = pd.DataFrame({
    '학생': [1, 2, 3],
    '$x_1$ 수업 참여 수': [4, 2, 5],
    '$x_2$ 프로젝트 시간': [5, 1, 8],
    '$y$ 기말 점수': [90, 20, 95],
})
score_data.to_html(index=False, border=0, escape=False)
표 1: 예시 데이터: 수업 참여 수, 프로젝트 시간, 기말 점수
학생 \(x_1\) 수업 참여 수 \(x_2\) 프로젝트 시간 \(y\) 기말 점수
1 4 5 90
2 2 1 20
3 5 8 95

학생은 세 명뿐이다. 행렬로 쓰면 \(X\)는 \(3 \times 2\), \(y\)는 \(3 \times 1\)이다. 첫 행은 \(x^{(1)} = [4, 5]\), \(y^{(1)} = 90\)이다. 이 세 명이 장 끝까지 예제로 쓰인다.


2. 순전파: 현재 가중치로 예측하기

학습을 시작하기 전, 가중치에는 아무 값이나 들어 있다. 그 상태의 신경망은 무엇을 내놓는가?

순전파 (Forward Pass)

입력노드에 데이터 한 건을 넣고, 왼쪽 층부터 차례로 합과 활성화를 계산해 출력노드까지 값을 흘려보내는 것. 앞 장에서 XOR을 계산할 때 한 일이 순전파다.

  • 순전파의 결과, 출력노드에 나온 값이 예측값 \(\hat{y}\)다
  • 데이터에 기록되어 있는 정답이 실제값 \(y\)다

입력노드 2개, 은닉노드 3개, 출력노드 1개로 인공신경망을 구성한다. 점수는 실수이므로 출력노드의 활성화 함수는 항등 함수 \(g(z) = z\)다. 은닉노드의 활성화 함수는 Sigmoid로 둔다.

현재 가중치가 다음과 같이 들어 있다고 하자. 학습 전이므로 아무 값이나 들어 있는 상태다. 앞 장처럼 아크 위에 가중치를 적는다. 색은 도착하는 노드별로 구분했다.

−5.23.90.7−0.8−0.2−0.81.4−1.50.4−1072.573.765.61편향x₁x₂1편향z₁z₂z₃ŷ입력층은닉층 (Sigmoid)출력층 (항등)

노드별로 합을 쓰면 다음과 같다. 각 노드로 들어오는 아크의 가중치를 그대로 옮긴 것이다.

  • \(z_1\) (빨강): 합 \(= -5.2 - 0.8\,x_1 + 1.4\,x_2\), 활성화 Sigmoid
  • \(z_2\) (파랑): 합 \(= 3.9 - 0.2\,x_1 - 1.5\,x_2\), 활성화 Sigmoid
  • \(z_3\) (초록): 합 \(= 0.7 - 0.8\,x_1 + 0.4\,x_2\), 활성화 Sigmoid
  • \(\hat{y}\) (보라): 합 \(= -10 + 72.5\,z_1 + 73.7\,z_2 + 65.6\,z_3\), 활성화 항등

첫 번째 학생 \(x^{(1)} = [4, 5]\)를 입력노드에 넣고 순전파한다.

코드
import pandas as pd

x1, x2 = 4, 5
a1 = -5.2 - 0.8*x1 + 1.4*x2;  h1 = SIG(a1)
a2 =  3.9 - 0.2*x1 - 1.5*x2;  h2 = SIG(a2)
a3 =  0.7 - 0.8*x1 + 0.4*x2;  h3 = SIG(a3)
ao = -10 + 72.5*h1 + 73.7*h2 + 65.6*h3;  y_hat = ao

pd.DataFrame([
    {'노드': '$z_1$', '합': f'−5.2 − 0.8×4 + 1.4×5 = {a1:.1f}', '활성화': f'σ({a1:.1f}) = {h1:.4f}'},
    {'노드': '$z_2$', '합': f'3.9 − 0.2×4 − 1.5×5 = {a2:.1f}', '활성화': f'σ({a2:.1f}) = {h2:.4f}'},
    {'노드': '$z_3$', '합': f'0.7 − 0.8×4 + 0.4×5 = {a3:.1f}', '활성화': f'σ({a3:.1f}) = {h3:.4f}'},
    {'노드': 'ŷ', '합': f'−10 + 72.5×{h1:.4f} + 73.7×{h2:.4f} + 65.6×{h3:.4f} = {ao:.2f}', '활성화': f'항등 → <b>{y_hat:.1f}</b>'},
]).to_html(index=False, border=0, escape=False)
표 2: 학생 1 (x⁽¹⁾ = [4, 5])의 순전파
노드 합 활성화
\(z_1\) −5.2 − 0.8×4 + 1.4×5 = -1.4 σ(-1.4) = 0.1978
\(z_2\) 3.9 − 0.2×4 − 1.5×5 = -4.4 σ(-4.4) = 0.0121
\(z_3\) 0.7 − 0.8×4 + 0.4×5 = -0.5 σ(-0.5) = 0.3775
ŷ −10 + 72.5×0.1978 + 73.7×0.0121 + 65.6×0.3775 = 30.00 항등 → 30.0
x₁4x₂5z₁0.1978z₂0.0121z₃0.3775ŷ30.0x⁽¹⁾ = [4, 5]Predicted: 30

현재 가중치로 이 학생의 기말 점수를 약 30점으로 예측했다. 그런데 실제값은 \(y^{(1)} = 90\)점이다.

Predicted ŷ: 30
Actual y: 90

60점이나 틀렸다. 가중치를 고치려면 먼저 얼마나 틀렸는지를 어떤 데이터에나 쓸 수 있는 숫자 하나로 만들어야 한다.


3. 손실: 한 건이 얼마나 틀렸나

손실 (Loss)

데이터 한 건에 대해, 예측값 \(\hat{y}\)와 실제값 \(y\)의 차이를 숫자 하나로 나타낸 값. 데이터 한 건마다 손실이 하나씩 나온다.

\(i\)번째 데이터의 손실을 \(\mathcal{L}\big(\hat{y}^{(i)}, y^{(i)}\big)\)로 쓴다. 클수록 많이 틀린 것이다.

차이를 숫자로 만드는 식은 문제 유형에 따라 다르다. 회귀에서는 제곱오차를 쓴다.

제곱오차 (Squared Error)

\[\mathcal{L}(\hat{y}, y) = (y - \hat{y})^2\]

회귀 문제에서 손실을 계산하는 식. 1장에서 잔차를 제곱했던 것과 같다. 부호를 없애고, 크게 틀릴수록 더 크게 벌한다.

학생 1의 손실은

\[\mathcal{L} = (90 - 30)^2 = 3600\]

이다. 여기서 한 가지를 눈여겨보자. 가중치가 달랐으면 순전파 결과 \(\hat{y}\)가 달랐고, 손실도 달랐을 것이다. 손실은 신경망의 가중치에 의해 결정된다.

학생은 세 명이다. 한 건씩 손실을 구했으면, 전체로는 얼마나 틀린 것인가?


4. 전체 손실: 데이터 전체가 얼마나 틀렸나

전체 손실

학습 데이터 모든 건의 손실을 평균한 값.

\[J = \frac{1}{n} \sum_{i=1}^{n} \mathcal{L}\big(\hat{y}^{(i)}, y^{(i)}\big)\]

현재 가중치가 주어진 데이터를 얼마나 잘 나타내고 있는지를 숫자 하나로 요약한다. 제곱오차의 평균은 평균제곱오차(MSE, Mean Squared Error)라 부른다. (영어 자료에서는 Empirical Loss라고도 쓴다.)

학생 2와 3도 같은 가중치로 순전파한다. 절차는 학생 1과 똑같다.

코드
import pandas as pd

rows = []
for i in range(3):
    rows.append({'학생': i + 1, '$x_1, x_2$': f'{int(EX_X[i,0])}, {int(EX_X[i,1])}',
                 '$z_1$': f'{EX_H[i,0]:.4f}', '$z_2$': f'{EX_H[i,1]:.4f}', '$z_3$': f'{EX_H[i,2]:.4f}',
                 'ŷ = −10 + 72.5z₁ + 73.7z₂ + 65.6z₃': f'<b>{EX_PRED[i]:.1f}</b>', '$y$': int(EX_Y[i])})
pd.DataFrame(rows).to_html(index=False, border=0, escape=False)
표 3: 세 학생의 순전파 — 은닉 활성화와 예측
학생 \(x_1, x_2\) \(z_1\) \(z_2\) \(z_3\) ŷ = −10 + 72.5z₁ + 73.7z₂ + 65.6z₃ \(y\)
1 4, 5 0.1978 0.0121 0.3775 30.0 90
2 2, 1 0.0045 0.8808 0.3775 80.0 20
3 5, 8 0.8808 0.0001 0.4750 85.0 95
x₁x₂z₁z₂z₃ŷX = [[4,5], [2,1], [5,8]]ŷ = [30, 80, 85] vs y = [90, 20, 95]

예측 \(\hat{y} = [30, 80, 85]\), 실제 \(y = [90, 20, 95]\)다. 세 손실을 구해 평균한다.

코드
import numpy as np
import pandas as pd

preds = [30, 80, 85]
actual = [90, 20, 95]

rows = []
for i, (p, y) in enumerate(zip(preds, actual), start=1):
    rows.append({'학생': i, 'ŷ (Predicted)': p, '$y$ (Actual)': y,
                 '$y - \\hat{y}$': y - p, '손실 $(y - \\hat{y})^2$': (y - p) ** 2})
mse = np.mean([(y - p) ** 2 for p, y in zip(preds, actual)])
rows.append({'학생': '평균', 'ŷ (Predicted)': '', '$y$ (Actual)': '', '$y - \\hat{y}$': '전체 손실 $J$',
             '손실 $(y - \\hat{y})^2$': f'<b>{mse:.1f}</b>'})
pd.DataFrame(rows).to_html(index=False, border=0, escape=False)
표 4: 전체 손실(MSE) 계산 — 학생 1, 2, 3
학생 ŷ (Predicted) \(y\) (Actual) \(y - \\hat{y}\) 손실 \((y - \\hat{y})^2\)
1 30 90 60 3600
2 80 20 -60 3600
3 85 95 10 100
평균 전체 손실 \(J\) 2433.3

전체 손실 2,433이 현재 가중치의 성적표다.

연습을 더 하려면: 도장 3주차의 유형 A가 이 계산이다.

\(y\)가 점수처럼 실수일 때는 이렇게 제곱오차를 쓴다. 그런데 \(y\)가 “합격/불합격”이라면 어떻게 하나?


5. 분류 문제의 손실: 교차 엔트로피

같은 학생 데이터에서 \(y\)를 시험 합격 여부 \(\{1: \text{pass},\ 0: \text{fail}\}\)로 바꾸자. 60점 이상이면 합격이다. \(y\)가 범주형이므로 분류 문제다.

코드
import pandas as pd

pass_data = pd.DataFrame({
    '학생': [1, 2, 3],
    '$x_1$ 수업 참여 수': [4, 2, 5],
    '$x_2$ 프로젝트 시간': [5, 1, 8],
    '기말 점수': [90, 20, 95],
    '$y$ 합격 여부': [1, 0, 1],
})
pass_data.to_html(index=False, border=0, escape=False)
표 5: 같은 데이터, y를 합격 여부로 바꾼 것
학생 \(x_1\) 수업 참여 수 \(x_2\) 프로젝트 시간 기말 점수 \(y\) 합격 여부
1 4 5 90 1
2 2 1 20 0
3 5 8 95 1

5.1 확률을 출력하기

확률 출력 (Sigmoid 출력층)

분류 문제에서는 특정 카테고리에 소속될 확률을 예측하는 것이 자연스럽다. 출력노드의 활성화 함수를 항등 함수에서 Sigmoid로 바꾸면 출력이 항상 0과 1 사이가 되고, 이것을 합격할 확률로 읽는다.

\[\hat{y} = \sigma(z) = \frac{1}{1 + e^{-z}}, \qquad 0 < \hat{y} < 1\]

x₁x₂z₁z₂z₃ŷ입력층은닉층 (Sigmoid)출력층 (Sigmoid → 확률)

구조는 회귀 때와 같고 출력노드의 활성화 함수만 다르다. 가중치는 이 문제에 맞게 따로 들어 있어야 한다. 그 신경망에서 학생 1을 순전파했을 때 출력노드의 합이 \(-2.15\)였다면 \(\hat{y} = \sigma(-2.15) = 0.104\), 합격 확률 약 0.1이다. 실제값은 합격(1)이다.

합이 어떤 값이어도 Sigmoid를 통과하면 0과 1 사이가 되는지 직접 확인한다. 슬라이더로 \(z\)를 움직이거나, 칸에 아주 큰 값이나 아주 작은 값을 넣어 보자.

인터랙티브 — 합 \(z\)가 무엇이든 Sigmoid의 출력은 0과 1 사이

\(z\)가 커질수록 1에, 작아질수록 0에 다가가지만 어느 쪽에도 닿지 않는다. 그래서 출력을 언제나 확률로 읽을 수 있다. \(z = 0\)이면 정확히 0.5다.

5.2 교차 엔트로피

실제값은 0 또는 1, 예측값은 확률이다. 이때 손실을 계산하는 식이 교차 엔트로피다.

교차 엔트로피 (Cross Entropy)

\[\mathcal{L}(\hat{y}, y) = -\Big[\, y \log \hat{y} + (1 - y) \log (1 - \hat{y}) \,\Big]\]

\(y\)는 0 또는 1이므로 대괄호 안의 두 항 중 하나만 살아남는다.

  • \(y = 1\)이면: \(\mathcal{L} = -\log \hat{y}\). 합격 확률을 높게 말했을수록 손실이 작다
  • \(y = 0\)이면: \(\mathcal{L} = -\log (1 - \hat{y})\). 합격 확률을 낮게 말했을수록 손실이 작다

제곱오차 대신 이 식을 쓰는 이유는, 확률이 정답에서 멀어질수록 손실이 급격히 커져 확신에 찬 오답을 크게 벌하기 때문이다. 아래 보드에서 확인한다.

학생 2와 3의 합격 확률도 각각 0.8, 0.6이 나왔다고 하자. 예측 \(\hat{y} = [0.1, 0.8, 0.6]\), 실제 \(y = [1, 0, 1]\)이다.

코드
import numpy as np
import pandas as pd

preds = [0.1, 0.8, 0.6]
actual = [1, 0, 1]

rows = []
for i, (p, y) in enumerate(zip(preds, actual), start=1):
    if y == 1:
        expr, loss = f'−log({p})', -np.log(p)
    else:
        expr, loss = f'−log(1 − {p}) = −log({1-p:.1f})', -np.log(1 - p)
    rows.append({'학생': i, 'ŷ (Predicted)': p, '$y$ (Actual)': y,
                 '살아남는 항': expr, '손실': f'{loss:.3f}',
                 '판정': '✗ 크게 틀림' if loss > 1 else '✓ 대체로 맞음'})
mean_loss = np.mean([-np.log(p) if y == 1 else -np.log(1-p) for p, y in zip(preds, actual)])
rows.append({'학생': '평균', 'ŷ (Predicted)': '', '$y$ (Actual)': '', '살아남는 항': '전체 손실 $J$',
             '손실': f'<b>{mean_loss:.3f}</b>', '판정': ''})

pd.DataFrame(rows).to_html(index=False, border=0, escape=False)
표 6: 교차 엔트로피 손실과 전체 손실 — 학생 1, 2, 3
학생 ŷ (Predicted) \(y\) (Actual) 살아남는 항 손실 판정
1 0.1 1 −log(0.1) 2.303 ✗ 크게 틀림
2 0.8 0 −log(1 − 0.8) = −log(0.2) 1.609 ✗ 크게 틀림
3 0.6 1 −log(0.6) 0.511 ✓ 대체로 맞음
평균 전체 손실 \(J\) 1.474

학생 1은 합격인데 0.1이라 했으니 \(-\log 0.1 = 2.303\)으로 손실이 크다. 학생 3은 합격에 0.6이라 했으니 \(-\log 0.6 = 0.511\)로 작다. 세 값의 평균 1.474가 현재 가중치의 전체 손실이다.

5.3 인터랙티브: 정답 확률과 손실

위 표는 확률 0.1, 0.8, 0.6 세 점의 손실만 보였다. 정의 박스에서 “정답에서 멀어질수록 손실이 급격히 커진다”고 한 말이 맞는지, 확률을 0에서 1까지 움직이며 손실 곡선 전체를 확인한다.

인터랙티브 — 예측 확률에 따른 교차 엔트로피 손실

실제 클래스(\(y\))를 선택하고 예측 확률(\(\hat{y}\))을 조절하면, 손실이 어떻게 변하는지 확인할 수 있습니다.

연습을 더 하려면: 도장 3주차의 유형 C(1건)와 유형 E(여러 건의 평균)가 이 계산이다.

합격/불합격처럼 클래스가 둘이면 여기까지다. 클래스가 셋 이상이면 어떻게 하나?


6. 다중 분류의 손실: Softmax와 다중 클래스 교차 엔트로피

클래스가 셋 이상인 문제를 다중 분류(multi-class classification)라 한다. 예를 들어 주어진 이미지를 고양이, 강아지, 소 중 하나로 분류하는 문제다.

  • 실제값 \(y\): \([\text{고양이}(1),\ \text{강아지}(0),\ \text{소}(0)]\) → 고양이가 정답. 정답 자리만 1인 이런 표현을 원-핫(one-hot)이라 한다
  • 예측값 \(\hat{y}\): \([\text{고양이}(0.8),\ \text{강아지}(0.1),\ \text{소}(0.1)]\) → 고양이로 분류될 확률이 높음

출력노드가 클래스 수만큼 3개 필요하고, 세 출력의 합이 1이 되어야 확률로 읽을 수 있다.

x₁x₂z₁z₂z₃ŷ₁ŷ₂ŷ₃입력층은닉층출력층 (Softmax)

6.1 Softmax

Softmax 함수

출력노드가 \(K\)개일 때, 각 노드의 합 \(z_1, \ldots, z_K\)를 합이 1인 확률로 바꾸는 활성화 함수.

\[S(z_k) = \frac{e^{z_k}}{\sum_{j=1}^{K} e^{z_j}}\]

각 클래스로 구별될 확률을 계산하기 위해 출력층에서 사용한다. \(e^{z}\)는 항상 양수이므로 모든 확률이 양수이고, 분모가 분자들의 합이므로 전체 합은 1이다.

세 출력노드의 합이 \(z = [2.0,\ 1.0,\ 0.1]\)이라 하자.

코드
import numpy as np
import pandas as pd

z = np.array([2.0, 1.0, 0.1])
ez = np.exp(z)
p = ez / ez.sum()

rows = [{'클래스': k, '$z_k$': z[i], '$e^{z_k}$': f'{ez[i]:.3f}',
         '$S(z_k) = e^{z_k} / \\sum e^{z_j}$': f'{ez[i]:.3f} / {ez.sum():.3f}', '확률': f'{p[i]:.3f}'}
        for i, k in enumerate(['고양이', '강아지', '소'])]
rows.append({'클래스': '합', '$z_k$': '', '$e^{z_k}$': f'<b>{ez.sum():.3f}</b>',
             '$S(z_k) = e^{z_k} / \\sum e^{z_j}$': '', '확률': f'<b>{p.sum():.1f}</b>'})
pd.DataFrame(rows).to_html(index=False, border=0, escape=False)
표 7: Softmax 계산 — z = [2.0, 1.0, 0.1]
클래스 \(z_k\) \(e^{z_k}\) \(S(z_k) = e^{z_k} / \\sum e^{z_j}\) 확률
고양이 2.0 7.389 7.389 / 11.213 0.659
강아지 1.0 2.718 2.718 / 11.213 0.242
소 0.1 1.105 1.105 / 11.213 0.099
합 11.213 1.0

가장 큰 합 \(z_1 = 2.0\)이 가장 큰 확률 0.659가 되었고, 세 확률의 합은 1이다.

6.2 다중 클래스 교차 엔트로피

다중 클래스 교차 엔트로피 (Categorical Cross Entropy)

\(i\)번째 데이터의 손실은

\[\mathcal{L}_i = -\sum_{j=1}^{K} t_{i,j} \log p_{i,j}\]

\(p_{i,j}\)는 Softmax가 낸 \(j\)번째 클래스의 확률, \(t_{i,j}\)는 원-핫 실제값(\(j\)가 정답이면 1, 아니면 0)이다. 정답 자리만 1이므로 결국 정답 클래스의 확률에 \(-\log\)를 취한 값 하나만 남는다. 앞 절 교차 엔트로피의 확장이다.

네 장의 이미지에 대한 예측 확률과 원-핫 실제값이 다음과 같다.

코드
import numpy as np
import pandas as pd

P = [[0.8, 0.1, 0.1], [0.2, 0.7, 0.1], [0.3, 0.3, 0.4], [0.9, 0.1, 0.1]]
T = [[1, 0, 0], [0, 1, 0], [0, 1, 0], [1, 0, 0]]
names = ['고양이', '강아지', '소']

rows, losses = [], []
for i, (p, t) in enumerate(zip(P, T), start=1):
    j = t.index(1)
    L = -np.log(p[j]); losses.append(L)
    rows.append({'이미지': i, 'ŷ = [고양이, 강아지, 소]': str(p), '$y$ (원-핫)': str(t),
                 '정답': names[j], '정답 확률 $p_{i,j}$': p[j], '손실 $-\\log p_{i,j}$': f'{L:.3f}'})
rows.append({'이미지': '평균', 'ŷ = [고양이, 강아지, 소]': '', '$y$ (원-핫)': '', '정답': '',
             '정답 확률 $p_{i,j}$': '전체 손실 $J$', '손실 $-\\log p_{i,j}$': f'<b>{np.mean(losses):.3f}</b>'})
pd.DataFrame(rows).to_html(index=False, border=0, escape=False)
표 8: 다중 클래스 교차 엔트로피 — 이미지 4장
이미지 ŷ = [고양이, 강아지, 소] \(y\) (원-핫) 정답 정답 확률 \(p_{i,j}\) 손실 \(-\\log p_{i,j}\)
1 [0.8, 0.1, 0.1] [1, 0, 0] 고양이 0.8 0.223
2 [0.2, 0.7, 0.1] [0, 1, 0] 강아지 0.7 0.357
3 [0.3, 0.3, 0.4] [0, 1, 0] 강아지 0.3 1.204
4 [0.9, 0.1, 0.1] [1, 0, 0] 고양이 0.9 0.105
평균 전체 손실 \(J\) 0.472

세 번째 이미지는 강아지가 정답인데 강아지 확률을 0.3밖에 주지 않아 손실 1.204로 가장 크다.

연습을 더 하려면: 도장 3주차의 유형 B(Softmax)와 유형 D(Softmax + 다중 클래스 교차 엔트로피)가 이 계산이다.

6.3 인터랙티브: 점수·확률·손실의 관계

이제 출력 점수에서 확률을 구하고, 정답 확률로 손실을 계산하는 과정을 함께 확인한다. 아래 초기 점수는 앞의 Softmax 예제와 같다. 고양이의 점수를 높인 뒤 고양이 확률과 손실이 어떻게 바뀌는지 확인한다.

인터랙티브 — Softmax 계산기

3개 클래스의 합 \(z_k\)를 조절하면, Softmax 확률과 손실이 실시간으로 계산됩니다.

회귀와 분류 모두 예측과 정답을 비교하여 전체 손실을 계산할 수 있다. 이제 이 손실을 이용해 가중치를 어떻게 학습하는지 살펴본다.


7. 좋은 가중치란 무엇인가

7.1 손실함수: 가중치와 전체 손실의 관계

앞에서는 주어진 가중치로 예측하고 전체 손실을 계산했다. 같은 데이터에서도 가중치를 바꾸면 예측이 달라지고, 전체 손실도 달라진다. 이제 데이터는 고정한 채, 가중치에 따라 전체 손실이 어떻게 달라지는지 살펴본다.

이 관계를 나타내는 함수가 손실함수 \(J(W)\)다. \(W\)는 학습할 가중치와 편향 전체를 묶어 쓴 기호다. \(J(W)\)는 가중치 \(W\)를 넣으면 그 가중치에서의 전체 손실이 나오는 함수다.

앞에서 구한 전체 손실의 식에 가중치를 명시하면 다음과 같다.

\[J(W)=\frac{1}{n}\sum_{i=1}^{n}\mathcal{L}\big(\hat{y}^{(i)}(W),\ y^{(i)}\big)\]

여기서 \(\hat{y}^{(i)}(W)\)는 가중치 \(W\)로 계산한 \(i\)번째 데이터의 예측값이다. 가중치가 달라지면 이 예측값이 바뀌고, 정답과 비교한 손실도 바뀐다.

7.2 손실 최소화: 학습이 찾으려는 것

학습 데이터에서 전체 손실이 작을수록 예측 오차가 작다. 따라서 학습의 목표는 손실함수를 최소로 만드는 가중치를 찾는 것이다. 그 가중치를 \(W^*\)라고 쓰면

\[W^*=\underset{W}{\operatorname{argmin}}\;J(W)\]

로 표현한다. \(\operatorname{argmin}\)은 함숫값을 최소로 만드는 입력을 뜻한다. 여기서 찾는 것은 가장 작은 손실값 자체가 아니라, 그 손실을 만드는 가중치다. 이처럼 가중치를 조절하여 손실을 최소로 만드는 문제를 손실 최소화라고 한다.

목표는 정해졌다. 이제 필요한 것은 현재 가중치를 어떻게 바꾸어야 손실이 줄어드는지 알아내는 방법이다.

7.3 가중치가 하나인 간단한 예제

앞의 신경망에는 가중치가 여러 개 있고, 예측 과정에도 여러 계산이 들어간다. 먼저 가중치 하나를 조절하는 원리부터 살펴보자. 가중치를 \(w\)라 하고, 손실함수가 다음과 같다고 가정한다.

\[J(w)=(w-2)^2\]

이 식은 앞의 학생 데이터에서 구한 손실함수가 아니다. 손실을 줄이는 방법을 배우기 위해 단순하게 정한 예제다. 이후 한 변수의 미분과 경사하강법을 설명할 때는 이 함수를 계속 사용한다.

그래프의 가로축은 우리가 바꾸는 가중치 \(w\), 세로축은 그 결과인 손실 \(J(w)\)다. 예를 들어 \(w=4\)이면 손실은 \((4-2)^2=4\)다. 가중치를 바꾸면 점이 곡선을 따라 움직인다.

아래에서 \(w=4\)를 기준으로 왼쪽과 오른쪽을 비교한다. 왼쪽으로 0.5를 누른 뒤, 처음으로를 눌러 돌아와 오른쪽으로 0.5를 누른다.

가중치를 왼쪽 또는 오른쪽으로 움직여 손실을 비교하는 인터랙티브입니다. JavaScript를 켜면 조작할 수 있습니다.

왼쪽으로 이동한 \(w=3.5\)에서는 손실이 \(2.25\)로 줄고, 오른쪽으로 이동한 \(w=4.5\)에서는 \(6.25\)로 늘어난다. 이 예제의 손실을 최소로 만드는 가중치는 \(w^*=2\)이고, 그때의 손실은 \(J(2)=0\)이다.

다만 가중치를 항상 줄이면 되는 것은 아니다. 시작 위치를 \(w=0\)으로 바꾸면, 이번에는 오른쪽으로 이동해야 손실이 줄어든다. 손실을 줄이는 방향은 현재 가중치가 어디에 있는지에 따라 달라진다.

8. 손실을 줄이는 방향은 어떻게 알 수 있는가

방금 확인한 두 위치를 같은 그래프에서 비교해 보자. \(w=4\) 주변에서는 오른쪽으로 갈수록 곡선이 올라간다. 따라서 왼쪽으로 조금 이동하면 손실이 줄어든다. 반대로 \(w=0\) 주변에서는 오른쪽으로 갈수록 곡선이 내려가므로, 오른쪽으로 조금 이동하면 손실이 줄어든다.

같은 손실 곡선에서도 현재 위치에 따라 손실을 줄이는 방향이 달라진다. w=0에서는 오른쪽으로, w=4에서는 왼쪽으로 조금 이동한다.

이를 현재 위치 주변의 기울기로 표현할 수 있다. 그래프를 오른쪽으로 읽을 때 올라가면 기울기는 양수, 내려가면 음수다.

현재 위치 주변의 기울기 손실을 줄이려면
양수: 오른쪽으로 올라간다 가중치를 조금 줄인다
음수: 오른쪽으로 내려간다 가중치를 조금 늘린다

즉, 기울기의 부호와 반대 방향으로 조금 이동한다. 여기서 조금이라는 조건이 중요하다. 현재 위치 주변에서 내려가는 방향이라도, 멀리 이동하면 최솟점을 지나 손실이 다시 커질 수 있다.

이 예제는 그래프를 보고 방향을 판단할 수 있다. 실제 학습에서는 복잡한 손실함수의 전체 그래프를 그려 판단하기 어렵다. 대신 현재 위치의 기울기를 계산하여 가중치를 조절할 방향을 정한다. 다음 절에서는 그 기울기를 어떻게 계산하는지 알아본다.

9. 현재 위치의 기울기를 구하는 방법: 미분

9.1 두 점 사이의 변화율

기울기를 수치로 구하려면, 가중치가 변할 때 손실이 얼마나 변하는지 비교해야 한다. 먼저 \(w=4\)에서 \(w=5\)로 이동하는 경우를 살펴보자.

  • 가중치는 \(5-4=1\)만큼 증가한다.
  • 손실은 \(J(5)-J(4)=9-4=5\)만큼 증가한다.

손실의 변화량을 가중치의 변화량으로 나눈 값은 다음과 같다.

\[\frac{\text{손실의 변화량}}{\text{가중치의 변화량}}=\frac{9-4}{5-4}=5\]

이를 두 점 사이의 평균 변화율이라고 한다. 이 구간에서는 가중치가 1 증가할 때 손실이 평균적으로 5 증가했다는 뜻이다. 그래프에서는 두 점을 잇는 직선의 기울기다.

9.2 관찰 구간을 좁히면 현재 위치의 기울기가 된다

우리가 필요한 것은 4부터 5까지의 평균이 아니라, 현재 위치 4에서의 기울기다. 곡선의 기울기는 위치에 따라 달라지므로, 관찰 구간을 더 좁혀야 한다.

시작점을 4로 고정하고 다른 점을 가까이 옮기면 다음과 같다.

가중치의 이동 가중치 변화량 손실 변화량 평균 변화율
\(4\to5\) \(1\) \(5\) \(5\)
\(4\to4.1\) \(0.1\) \(0.41\) \(4.1\)
\(4\to4.01\) \(0.01\) \(0.0401\) \(4.01\)

구간을 좁힐수록 변화율은 4에 가까워진다. 두 점을 잇는 직선도 현재 점에서 곡선의 방향을 나타내는 접선에 가까워진다.

아래에서 두 점 사이의 간격을 줄여 직선과 변화율을 함께 확인한다. 접근하는 쪽을 왼쪽으로 바꾸어도 같은 값에 가까워진다.

두 점 사이의 간격을 줄여 평균 변화율이 접선의 기울기에 가까워지는 과정을 확인하는 인터랙티브입니다.

이처럼 관찰 구간을 한없이 좁혔을 때의 변화율을 미분값이라고 한다. 미분값은 현재 점의 접선 기울기이며, 이를 구하는 것이 미분이다.

가중치 변화량을 \(h\)라고 쓰면, 현재 위치 \(w\)에서의 미분값은 다음과 같이 정의한다.

\[J'(w)=\lim_{h\to0}\frac{J(w+h)-J(w)}{h}\]

\(h\to0\)은 가중치 변화량을 0에 가깝게 줄인다는 뜻이다. \(h=0\)을 넣어 나누는 것이 아니라, 0에 가까워질 때 변화율이 다가가는 값을 구한다. 위에서 확인한 \(w=4\)의 미분값은 \(J'(4)=4\)다.

9.3 현재 가중치를 넣으면 미분값이 나오는 식

다른 위치에서도 같은 방법으로 미분값을 구할 수 있다. 다만 매번 두 점을 가까이 옮겨 계산하는 것은 번거롭다. 현재 가중치 \(w\)를 넣으면 그 위치의 미분값이 나오는 함수를 구해 두면 편리하다. 이 함수를 도함수 \(J'(w)\)라고 한다.

우리 예제의 도함수를 구해 보자. 먼저 평균 변화율의 식에 \(J(w)=(w-2)^2\)를 넣고 분자를 전개한다.

\[\begin{aligned} \frac{J(w+h)-J(w)}{h} &=\frac{(w+h-2)^2-(w-2)^2}{h}\\ &=\frac{2(w-2)h+h^2}{h}\\ &=2(w-2)+h \end{aligned}\]

여기서 \(h\)가 0에 가까워지면 마지막 항이 사라진다. 따라서 도함수는

\[\boxed{J'(w)=2(w-2)}\]

다. 이제 현재 가중치를 이 식에 넣으면 바로 기울기를 계산할 수 있다.

현재 가중치 도함수에 대입한 미분값 손실을 줄이는 방향
\(w=4\) \(J'(4)=4\) 왼쪽: 가중치를 줄인다
\(w=0\) \(J'(0)=-4\) 오른쪽: 가중치를 늘린다
\(w=2\) \(J'(2)=0\) 이 예제의 최솟점이다

\(J(w)\)에 가중치를 넣으면 손실이 나오고, \(J'(w)\)에 가중치를 넣으면 그 위치의 기울기가 나온다. 손실을 계산하는 식과, 손실을 줄일 방향을 알려주는 식의 역할이 다르다.

10. 가중치를 반복해서 조절하는 방법: 경사하강법

10.1 미분에서 경사하강법으로

앞 절에서는 도함수를 이용해 임의의 가중치에서 손실함수의 기울기를 구하는 방법을 배웠다. 이제 현재 위치의 기울기를 계산할 수 있으므로, 그 반대 방향으로 조금 이동하여 손실을 줄일 수 있다.

한 번 이동한 뒤에는 새 위치에서 기울기를 구하고, 기울기의 음의 방향(함수의 값을 감소시키는 방향)으로 조금 움직인다. 그렇게 움직인 위치에서 같은 과정을 반복한다. 어느 순간 더 이상 감소가 되지 않고 한곳에 수렴한다면 그 점이 함수를 최소화시키는 값이라고 생각할 수 있다. 이 같은 절차를 이용하여 손실함수를 최소화하는 가중치를 찾아내는 방법을 경사하강법(Gradient Descent)이라고 한다.

10.2 경사하강법의 알고리즘

이 아이디어를 계산으로 옮기면 다음 갱신식을 얻는다. \(\eta\)(에타)는 이동 크기를 조절하는 양수이며, 학습률이라고 한다.

\[\boxed{w_{\text{새}}=w-\eta J'(w)}\]

현재 가중치에서 미분값에 학습률을 곱한 양을 뺀다. 미분값이 양수이면 가중치가 줄고, 음수이면 가중치가 늘어나므로 기울기의 반대 방향으로 이동한다.

경사하강법의 절차는 다음과 같다.

  1. 초기값을 정한다. 시작 가중치 \(w\), 학습률 \(\eta>0\), 반복 횟수를 정한다.
  2. 미분값을 계산한다. 현재 가중치 \(w\)를 도함수에 넣어 \(J'(w)\)를 구한다.
  3. 가중치를 갱신한다. \(w_{\text{새}}=w-\eta J'(w)\)를 계산하고, 현재 가중치를 이 값으로 바꾼다.
  4. 반복 여부를 확인한다. 정한 횟수만큼 갱신했으면 종료하고, 그렇지 않으면 2로 돌아간다.

이 절차를 앞의 손실함수 \(J(w)=(w-2)^2\)에 적용해 보자. 시작 가중치는 \(w=4\), 학습률은 \(\eta=0.1\)로 정한다. 도함수 \(J'(w)=2(w-2)\)에 현재 가중치를 넣으면 미분값은 4이므로, 첫 갱신은 다음과 같다.

\[w_{\text{새}}=4-0.1\times4=3.6\]

손실은 \(J(4)=4\)에서 \(J(3.6)=2.56\)으로 줄어든다. 다음 반복에서는 갱신된 가중치에서 미분값을 다시 계산한다. 새 미분값은 \(J'(3.6)=3.2\)이고, 다음 가중치는 \(3.6-0.1\times3.2=3.28\)이다.

갱신 횟수 현재 가중치 \(w\) 현재 미분값 \(J'(w)\) 현재 손실 \(J(w)\)
0 \(4\) \(4\) \(4\)
1 \(3.6\) \(3.2\) \(2.56\)
2 \(3.28\) \(2.56\) \(1.6384\)
3 \(3.024\) \(2.048\) \(1.0486\)

손실은 소수점 넷째 자리까지 표시했다.

10.3 학습률의 의미

위 계산에서는 학습률을 0.1로 정했다. 이 값을 바꾸면 한 번의 이동이 어떻게 달라질까?

학습률은 미분값에 곱하여 이동 크기를 조절하는 값이다. 현재 미분값이 4일 때, 학습률이 0.1이면 이동량은 \(-0.4\)이고, 0.5이면 \(-2\)다. 같은 미분값에서 학습률이 작으면 적게, 크면 많이 이동한다. 같은 학습률을 쓰더라도 위치에 따라 미분값이 달라지면 이동 크기도 달라진다.

크게 이동하면 최솟점에 더 빨리 가까워질 수 있지만, 너무 크게 이동하면 최솟점을 지나 손실이 다시 커질 수 있다. 아래에서 먼저 한 번 이동을 눌러 위 표의 값과 비교한 뒤, 학습률을 바꾸어 자동 반복을 실행한다. 학습률이나 시작 위치를 바꾸면 갱신 횟수와 경로가 초기화된다.

초록 화살표는 현재 기울기가 가리키는 손실 증가 방향이다. 파란 화살표는 학습률을 적용한 다음 갱신을 나타내며, 빈 점이 다음 위치다. 두 화살표를 비교하면 기울기의 반대 방향으로 가중치를 바꾸는 과정을 볼 수 있다.

학습률과 시작 위치를 정하고 경사하강법의 갱신을 한 번씩 또는 자동으로 실행하는 인터랙티브입니다.

학습률 0.1에서는 가중치가 2에, 손실이 0에 가까워진다. 이처럼 반복되는 값이 일정한 값에 가까워지는 것을 수렴이라고 한다.

같은 시작 위치 \(w=4\)에서 학습률에 따른 결과를 비교하면 다음과 같다.

학습률 관찰할 결과
\(0.1\) 가중치가 최솟점에 점차 가까워진다
\(1.0\) \(w=4\)와 \(w=0\)을 오가며 손실이 줄지 않는다
\(1.1\) 최솟점의 양쪽을 오가며 점점 멀어진다

미분값은 현재 위치 주변의 변화를 알려준다. 학습률이 너무 커서 그 주변을 벗어나면 손실이 증가할 수 있다. 또한 일반적인 손실함수에서는 경사하강법이 전체에서 가장 낮은 손실에 도달한다고 보장할 수 없다. 미분값이 0인 점도 항상 최솟점인 것은 아니다.

11. 가중치가 여러 개라면: 편미분과 기울기 벡터

신경망에는 가중치가 여러 개이므로, 각각을 어느 방향으로 바꿀지 알아야 한다. 가중치가 두 개인 다음 손실함수를 가정하자.

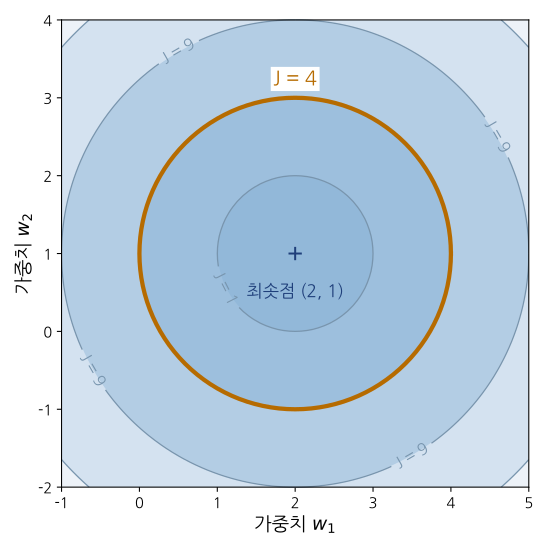
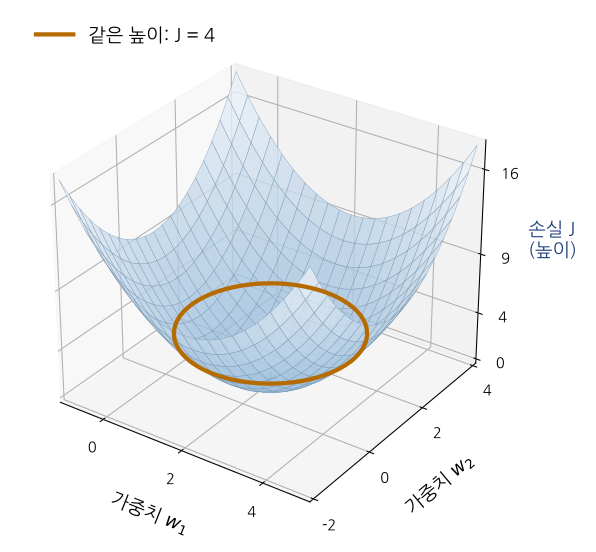
\[J(w_1,w_2)=(w_1-2)^2+(w_2-1)^2\]

두 가중치를 바닥의 두 축에 놓고 손실을 높이로 표시하면 3차원 그래프가 된다. 이를 위에서 내려다보며 같은 손실을 갖는 점들을 연결한 것이 등고선이다. 두 그림의 주황색 선은 모두 \(J=4\)를 나타내며, 이 예제에서는 중심에 가까울수록 손실이 작다.

손실을 높이로 표시한 3차원 그래프

같은 손실을 갖는 점들을 연결한 등고선 그림

11.1 하나만 바꾸어 각 가중치의 영향 구하기

\(w_1\)을 어느 방향으로 바꾸어야 손실이 줄어드는지 판단하려면, 다른 가중치 \(w_2\)를 고정한 상태에서 \(w_1\)에 대한 변화율을 구해야 한다. 따라서 \(w_1\)으로 미분할 때 \(w_2\)는 상수로 취급한다.

이처럼 다른 변수를 상수로 취급하여 한 변수에 대해 미분하는 것이 편미분이다. \(w_1\)에 대한 편미분은 \(\frac{\partial J}{\partial w_1}\)로 쓴다. 두 가중치에 각각 적용하면 다음과 같다.
\[\frac{\partial J}{\partial w_1}=2(w_1-2),\qquad \frac{\partial J}{\partial w_2}=2(w_2-1)\]

11.2 편미분값을 모은 기울기 벡터

각 편미분값은 숫자 하나다. 이를 변수 순서대로 모은 것이 기울기 벡터(gradient)이며, \(\nabla J\)로 쓴다. 현재 위치가 \((4,0)\)이면 다음과 같다.

\[\nabla J(w_1,w_2)= \begin{bmatrix} \dfrac{\partial J}{\partial w_1}\\[4pt] \dfrac{\partial J}{\partial w_2} \end{bmatrix},\qquad \nabla J(4,0)=\begin{bmatrix}4\\-2\end{bmatrix}\]

기울기 벡터는 현재 위치에서 손실이 가장 빠르게 증가하는 방향을 나타낸다. 따라서 손실을 줄이려면 그 반대 방향으로 조금 이동한다. 위 벡터 \((4,-2)\)는 오른쪽 아래를 가리키므로, 손실을 줄이는 방향은 왼쪽 위다.

아래에서 두 가중치를 바꾸어 방향을 확인한다. 가로·세로 화살표는 각 편미분값을, 초록색 화살표는 이를 합친 기울기 벡터를 나타낸다.

두 가중치를 움직여 편미분값과 기울기 벡터의 방향을 함께 확인하는 인터랙티브입니다.

11.3 같은 위치에서 계산하여 함께 갱신하기

이제 두 가중치를 기울기 벡터의 반대 방향으로 갱신한다. 두 가중치를 모은 벡터를 \(\mathbf{w}\)라고 쓰면 갱신식은 다음과 같다.

\[\mathbf{w}_{\text{새}}=\mathbf{w}-\eta\nabla J(\mathbf{w})\]

두 편미분값은 모두 갱신 전의 같은 위치에서 계산한다. 현재 위치 \((4,0)\)에서 학습률 0.1을 적용한 결과는 다음과 같다.

\[\begin{aligned} w_{1,\text{새}}&=4-0.1\times4=3.6\\ w_{2,\text{새}}&=0-0.1\times(-2)=0.2 \end{aligned}\]

새 위치에서 기울기를 다시 계산하며 같은 과정을 반복한다.

갱신 횟수 현재 가중치 \((w_1,w_2)\) 기울기 벡터 현재 손실
0 \((4,0)\) \((4,-2)\) \(5\)
1 \((3.6,0.2)\) \((3.2,-1.6)\) \(3.2\)
2 \((3.28,0.36)\) \((2.56,-1.28)\) \(2.048\)

아래에서 한 번 이동을 눌러 위 표의 값과 비교한다.

두 가중치를 기울기 벡터로 함께 갱신하고, 손실의 등고선 위에서 이동 경로를 확인하는 인터랙티브입니다.

가중치가 더 많아져도 같은 원리로 갱신한다.

12. 신경망의 학습으로 연결하기

이제 앞부분의 신경망으로 돌아가자. 신경망의 손실함수는 연습에 사용한 이차함수보다 복잡하지만, 학습에서 해야 할 일은 같다. 현재 가중치로 손실을 계산하고, 각 가중치의 기울기를 구하여 갱신한다.

  1. 예측한다. 학습 데이터를 넣고 현재 가중치로 순전파한다.
  2. 손실을 계산한다. 예측과 정답을 비교하여 전체 손실 \(J(W)\)를 구한다.
  3. 기울기를 계산한다. 현재 가중치에서 각 가중치와 편향에 대한 편미분값을 구한다.
  4. 가중치를 갱신한다. 각 값에서 학습률과 해당 편미분값을 곱한 양을 뺀다.
  5. 반복한다. 갱신한 가중치로 다시 예측하는 단계부터 수행한다.

모든 가중치와 편향을 하나의 벡터 \(W\)로 모아 쓰면 갱신식은 다음과 같다. \(\leftarrow\)는 계산한 새 값으로 바꾼다는 뜻이다.

\[W\leftarrow W-\eta\nabla J(W)\]

\(J(W)\)는 현재 예측이 얼마나 틀렸는지 평가하고, \(\nabla J(W)\)는 가중치를 조절할 방향과 크기를 정하는 데 사용한다. 다음 장에서는 신경망의 여러 층을 거쳐 이 기울기를 계산하는 방법인 역전파를 배운다.

경사하강법 도장에서 한 번의 갱신을 연습할 수 있다.

13. 참고: 작은 이동에서 손실이 감소하는 이유

현재 위치에서 \(J\)가 미분 가능하고, 미분값을 \(g=J'(w)\ne0\)이라고 하자. 미분값은 작은 이동에서의 손실 변화를 다음과 같이 알려준다.

\[\text{손실 변화}\approx g\times\text{이동량}\]

경사하강법에서 정한 이동량 \(-\eta g\)를 넣으면

\[\text{손실 변화}\approx g\times(-\eta g)=-\eta g^2\]

이다. 첫 번째 \(g\)는 손실이 변하는 비율이고, 두 번째 \(g\)는 우리가 정한 이동량의 일부다. 이 둘을 곱해서 제곱이 나온다. \(\eta>0\)이고 \(g\ne0\)이면 이 근삿값은 음수다.

실제 손실도 감소함을 보이려면 미분의 정의를 사용한다.

\[\begin{aligned} \lim_{\eta\to0^+}\frac{J(w-\eta g)-J(w)}{\eta} &=(-g)\lim_{\eta\to0^+}\frac{J(w-\eta g)-J(w)}{-\eta g}\\ &=(-g)J'(w)=-g^2<0 \end{aligned}\]

극한값이 음수이므로, 충분히 작은 양수 \(\eta\)에서는 분수의 값도 음수다. 분모 \(\eta\)가 양수이므로 \(J(w-\eta g)-J(w)<0\), 즉 손실이 감소한다.

이는 미분값이 0이 아닌 현재 위치에서, 충분히 작은 이동이 손실을 줄인다는 근거다. 임의의 학습률에서 항상 감소하거나, 반복하면 반드시 전체 최솟값에 도달한다는 뜻은 아니다.