실습 4-2 · 배치로 학습하고, 멈출 곳을 고르고, 한 번만 평가하기

Open In Colab

Open In Colab

⏱ 60분 · 4주차 실습 2/2 — (4-1) 표를 학습할 수 있는 형태로 만들기 → 배치로 학습하고, 멈출 곳을 고르고, 한 번만 평가하기

🎯 이번 시간의 질문

4-1에서 표를 세 세트로 나누고 배치로 꺼낼 수 있게 만들었습니다. 이제 학습입니다.

언제 학습을 멈추고, 새 자동차에서 얼마나 틀리는지 어떻게 말할까요?

실습 3의 학습 다섯 줄을 배치마다 돌리면 한 에폭이고, 에폭마다 검증 손실을 재면 언제 멈출지가 보이고, 마지막에 테스트 세트로 한 번 재면 새 데이터에 대한 성능이 됩니다.

이번 시간에 반복할 패턴: 배치 하나에 다섯 줄 → for로 한 에폭 → 함수로 조립 · model.eval()과 torch.no_grad()로 평가 · state_dict를 복사해 두었다가 되돌리기.

대응 이론: Ch04 학습의 실전

교수자 메모 (실습본에는 없음). 60분 운영: 준비 셀 2분 → 1·2절 모델 준비·다섯 줄·한 에폭 13분 → 3절 평가 함수 8분 → 4절 200 에폭과 러닝커브 10분 → 5절 복사·복원과 조립 12분 → 6절 테스트 5분 → 📝 과제 10분. ✅ 숫자는 각 절의 체크포인트 참조. 테스트 RMSE 약 2.5, 기준선 약 7.1.

# ▶ 준비 셀 — 그대로 실행하세요. 4-1에서 만든 세 세트·전처리·텐서·로더를 다시 만들고, 모델과 손실·갱신 도구를 준비합니다.
import pandas as pd
import torch
import torch.nn as nn
import copy
from sklearn.model_selection import train_test_split
from torch.utils.data import TensorDataset, DataLoader

URL = 'https://raw.githubusercontent.com/ralbu85/Lecture_DeepLearning_2022/main/auto.csv'
auto = pd.read_csv(URL)
num_cols = ['cylinders', 'displacement', 'horsepower', 'weight', 'acceleration', 'model_year']

train_df, rest_df = train_test_split(auto, test_size=0.3, random_state=42)
val_df, test_df = train_test_split(rest_df, test_size=0.5, random_state=42)
mu = train_df[num_cols].mean()
sd = train_df[num_cols].std(ddof=0)

def prep(df):
    out = df.copy()
    out[num_cols] = (out[num_cols] - mu) / sd
    out['origin'] = pd.Categorical(out['origin'], categories=[1, 2, 3])
    return pd.get_dummies(out, columns=['origin'])

def to_tensor(df):
    X = torch.tensor(df.drop(columns='mpg').to_numpy(dtype='float32'))
    y = torch.tensor(df[['mpg']].to_numpy(dtype='float32'))
    return X, y

X_tr, y_tr = to_tensor(prep(train_df))
X_va, y_va = to_tensor(prep(val_df))
X_te, y_te = to_tensor(prep(test_df))

train_loader = DataLoader(TensorDataset(X_tr, y_tr), batch_size=32, shuffle=True)
val_loader = DataLoader(TensorDataset(X_va, y_va), batch_size=64)
test_loader = DataLoader(TensorDataset(X_te, y_te), batch_size=64)
print(X_tr.shape, len(train_loader))
print("준비 완료!")
torch.Size([274, 9]) 9
준비 완료!

✅ torch.Size([274, 9]) 9와 준비 완료!가 나오면 됩니다.


1. 모델과 도구를 준비하고 배치 하나에 다섯 줄

모델은 실습 3처럼 nn.Sequential로 만듭니다. 입력 9개를 받아 은닉층 32개와 16개를 거쳐 숫자 하나를 냅니다. 손실은 실습 3과 같은 MSELoss입니다. 갱신 도구는 Adam을 씁니다. SGD처럼 기울기의 반대 방향으로 가되 파라미터마다 이동 폭을 스스로 조절합니다. torch.manual_seed(42)는 초기 가중치를 고정합니다.

# ✍️ 직접 입력
torch.manual_seed(42)
model = nn.Sequential(
    nn.Linear(9, 32), nn.ReLU(),
    nn.Linear(32, 16), nn.ReLU(),
    nn.Linear(16, 1),
)
criterion = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
print(model)
Sequential(
  (0): Linear(in_features=9, out_features=32, bias=True)
  (1): ReLU()
  (2): Linear(in_features=32, out_features=16, bias=True)
  (3): ReLU()
  (4): Linear(in_features=16, out_features=1, bias=True)
)

💬 결과 해설 — 층 다섯 개가 순서대로 보입니다. Linear(9→32), ReLU, Linear(32→16), ReLU, Linear(16→1). 앞 층의 출력 수가 다음 층의 입력 수와 맞습니다.

4-1에서 한 대로 로더에서 첫 배치를 꺼냅니다.

# ✍️ 직접 입력
xb, yb = next(iter(train_loader))
print(xb.shape, yb.shape)
torch.Size([32, 9]) torch.Size([32, 1])

✅ 체크포인트 — (32, 9)와 (32, 1)이면 맞습니다. 이 배치에 실습 3의 다섯 줄을 그대로 적용합니다.

# ✍️ 직접 입력
optimizer.zero_grad()
pred = model(xb)
loss = criterion(pred, yb)
loss.backward()
optimizer.step()
print(loss.item())
528.8167724609375

💬 결과 해설 — 약 529입니다. 이 배치 32건의 손실이고, 연비의 제곱 단위이므로 수백이 나옵니다. 가중치는 이 배치의 기울기로 한 번 갱신되었습니다.

로더에서 다음 배치를 꺼내 같은 다섯 줄을 실행합니다.

# ✍️ 직접 입력
xb, yb = next(iter(train_loader))
optimizer.zero_grad()
pred = model(xb)
loss = criterion(pred, yb)
loss.backward()
optimizer.step()
print(loss.item())
657.661376953125

💬 결과 해설 — 약 658입니다. 다른 32건이므로 손실값이 다릅니다. 배치마다 이렇게 한 번씩 갱신합니다.


2. 모든 배치를 돌면 한 에폭

for로 로더의 배치를 차례로 꺼내 다섯 줄을 실행합니다. 배치 손실은 그 배치의 평균이므로 배치 크기 len(yb)를 곱해 합으로 되돌려 total에 모으고, 건수는 n에 모읍니다. 마지막에 total / n이 에폭의 평균 손실입니다.

# ✍️ 직접 입력
total = 0.0
n = 0
for xb, yb in train_loader:
    optimizer.zero_grad()
    pred = model(xb)
    loss = criterion(pred, yb)
    loss.backward()
    optimizer.step()
    total += loss.item() * len(yb)
    n += len(yb)

print(n, total / n)
274 578.8400364339786

💬 결과 해설 — n은 274로 훈련 세트 전체이고, 두 번째 값 약 579이 한 에폭의 평균 훈련 손실입니다.

이 코드를 함수로 조립합니다. 앞에 model.train()을 붙입니다. 모델을 학습 모드로 두는 줄입니다. 빈칸을 채웁니다.

# ✍️ 빈칸(___)을 채운 뒤 실행하세요
#* def train_one_epoch(model, loader, criterion, optimizer):
#*     model.train()
#*     total = 0.0
#*     n = 0
#*     for xb, yb in loader:
#*         ___            # 이전 기울기 지우기
#*         pred = ___     # 예측
#*         loss = ___     # 손실
#*         ___            # 기울기 계산
#*         ___            # 가중치 갱신
#*         total += loss.item() * len(yb)
#*         n += len(yb)
#*     return total / n
#*
#* print(train_one_epoch(model, train_loader, criterion, optimizer))
def train_one_epoch(model, loader, criterion, optimizer):
    model.train()
    total = 0.0
    n = 0
    for xb, yb in loader:
        optimizer.zero_grad()
        pred = model(xb)
        loss = criterion(pred, yb)
        loss.backward()
        optimizer.step()
        total += loss.item() * len(yb)
        n += len(yb)
    return total / n

print(train_one_epoch(model, train_loader, criterion, optimizer))
364.2476137258711

💬 결과 해설 — 약 364입니다. 한 에폭을 더 돌아 앞의 값보다 줄었습니다.


3. 검증 손실은 가중치를 바꾸지 않고 잰다

검증 세트로는 손실만 잽니다. 실습 3의 7.3절처럼 torch.no_grad() 안에서 계산합니다. model.eval()은 모델을 평가 모드로 바꿉니다. 드롭아웃처럼 학습과 평가에서 다르게 동작하는 층을 전환하는 줄입니다.

# ✍️ 직접 입력
model.eval()
with torch.no_grad():
    val_loss = criterion(model(X_va), y_va)
print(val_loss.item())
154.46697998046875

💬 결과 해설 — 약 154.5입니다. 검증 59건의 평균 손실입니다.

로더로 배치마다 손실을 구해 합치면 같은 값이 나옵니다. 데이터가 커서 한 번에 못 넣을 때는 이렇게 합니다.

# ✍️ 직접 입력
total = 0.0
n = 0
with torch.no_grad():
    for xb, yb in val_loader:
        total += criterion(model(xb), yb).item() * len(yb)
        n += len(yb)
print(total / n)
154.46697998046875

✅ 체크포인트 — 바로 위와 같은 값이면 맞습니다.

이 코드를 함수로 조립합니다. 빈칸을 채웁니다.

# ✍️ 빈칸(___)을 채운 뒤 실행하세요
#* def evaluate(model, loader, criterion):
#*     model.___()
#*     total = 0.0
#*     n = 0
#*     with torch.___():
#*         for xb, yb in loader:
#*             total += criterion(model(xb), yb).item() * len(yb)
#*             n += len(yb)
#*     return total / n
#*
#* print(evaluate(model, val_loader, criterion))
def evaluate(model, loader, criterion):
    model.eval()
    total = 0.0
    n = 0
    with torch.no_grad():
        for xb, yb in loader:
            total += criterion(model(xb), yb).item() * len(yb)
            n += len(yb)
    return total / n

print(evaluate(model, val_loader, criterion))
154.46697998046875

✅ 체크포인트 — 역시 같은 값이면 맞습니다. 이제 학습 함수와 평가 함수가 갖춰졌습니다.


4. 200 에폭을 돌며 두 손실을 기록한다

에폭마다 두 함수를 한 번씩 부르고, 실습 3의 loss_history처럼 두 손실을 리스트에 기록합니다.

# ✍️ 직접 입력
train_history = []
val_history = []

for epoch in range(200):
    tr = train_one_epoch(model, train_loader, criterion, optimizer)
    va = evaluate(model, val_loader, criterion)
    train_history.append(tr)
    val_history.append(va)

print("첫 에폭   훈련:", train_history[0], " 검증:", val_history[0])
print("마지막    훈련:", train_history[-1], " 검증:", val_history[-1])
첫 에폭   훈련: 75.1352120281136  검증: 84.39102172851562
마지막    훈련: 4.0184021448566964  검증: 5.987189769744873

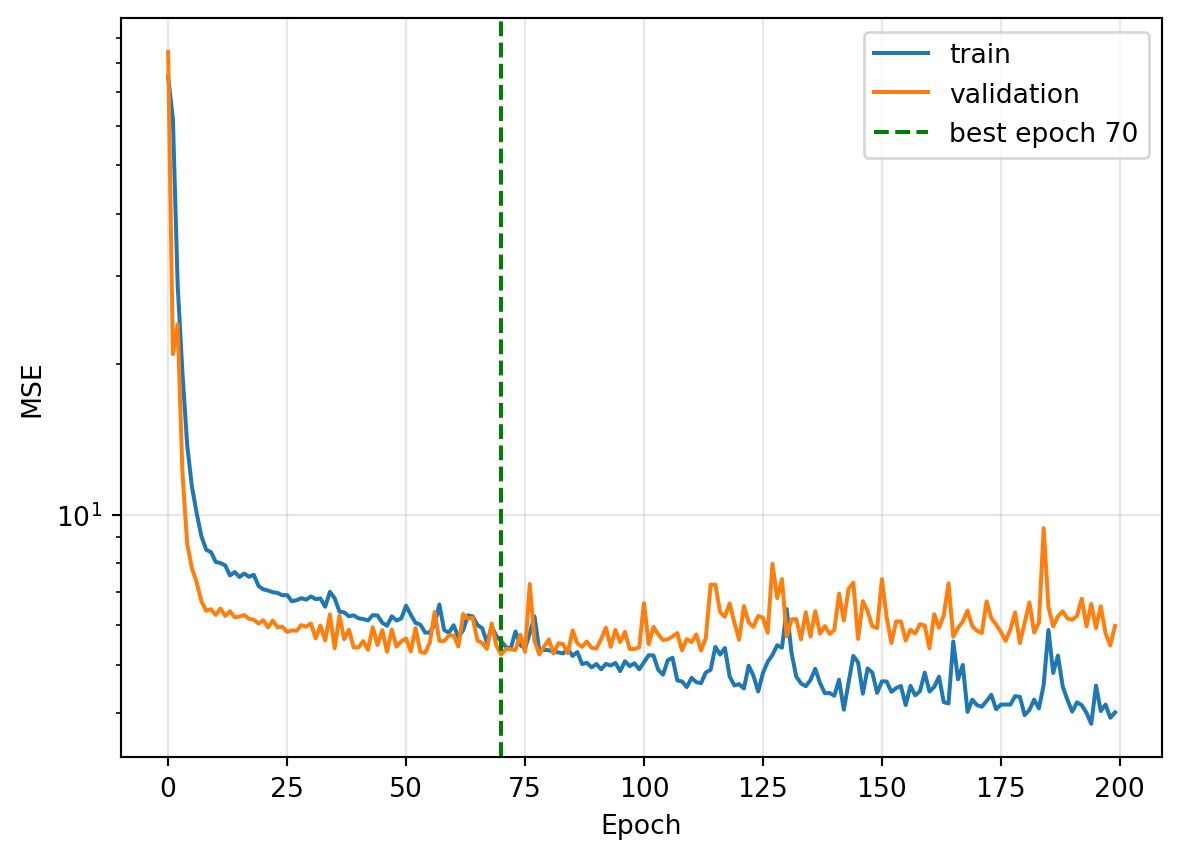
💬 결과 해설 — 훈련 손실은 약 75에서 4.0로, 검증 손실은 약 84에서 6.0로 줄었습니다.

검증 손실이 가장 낮았던 에폭을 찾습니다. min은 리스트의 최솟값, .index는 그 값이 몇 번째에 있는지 돌려줍니다.

# ✍️ 직접 입력
best_epoch = val_history.index(min(val_history))
print(best_epoch, min(val_history))
70 5.243985652923584

💬 결과 해설 — 70번째 에폭의 약 5.2가 최솟값입니다. 마지막 에폭의 검증 손실 6.0은 이보다 큽니다. 그 에폭 이후로는 더 돌려도 새 데이터에 대한 성능이 나아지지 않았습니다.

그림으로 봅니다.

# ▶ 그대로 실행하세요 — 러닝커브
import matplotlib.pyplot as plt

plt.plot(train_history, label='train')
plt.plot(val_history, label='validation')
plt.axvline(best_epoch, color='green', linestyle='--', label=f'best epoch {best_epoch}')
plt.yscale('log')
plt.xlabel('Epoch')
plt.ylabel('MSE')
plt.legend()
plt.grid(alpha=0.3)
plt.show()

💬 결과 해설 — 훈련 손실은 계속 내려가고, 검증 손실은 초록 선 이후 다시 오릅니다. 이론에서 본 과적합의 모양입니다.

훈련 손실 검증 손실 진단
높다 높다 과소적합
낮다 내려가다 올라간다 과적합
낮다 낮다 적절

5. 가장 좋았던 가중치로 되돌린다

모델의 가중치와 편향은 model.state_dict()에 들어 있습니다. 이름과 텐서의 사전입니다.

# ✍️ 직접 입력
state = model.state_dict()
print(list(state.keys()))
print(state['4.bias'].item())
['0.weight', '0.bias', '2.weight', '2.bias', '4.weight', '4.bias']
0.20894257724285126

💬 결과 해설 — 층 번호와 weight/bias로 이름이 붙어 있습니다. 4.bias는 마지막 Linear 층의 편향 하나로, 약 0.2089입니다.

copy.deepcopy로 지금 값을 따로 복사합니다. 그 뒤 다섯 에폭 더 학습하면 모델의 값은 바뀌지만 복사본은 그대로입니다.

# ✍️ 직접 입력
saved = copy.deepcopy(model.state_dict())
for epoch in range(5):
    train_one_epoch(model, train_loader, criterion, optimizer)

print("복사본:", saved['4.bias'].item())
print("모델  :", model.state_dict()['4.bias'].item())
복사본: 0.20894257724285126
모델  : 0.2085271179676056

✅ 체크포인트 — 복사본은 0.2089 그대로이고 모델은 0.2085로 바뀌었으면 맞습니다. deepcopy가 없으면 복사본도 모델을 따라 바뀝니다.

load_state_dict로 복사본을 모델에 다시 넣습니다.

# ✍️ 직접 입력
model.load_state_dict(saved)
print(model.state_dict()['4.bias'].item())
0.20894257724285126

✅ 체크포인트 — 복사본의 값 0.2089로 돌아왔으면 맞습니다.

이제 조립합니다. 새 모델로 다시 학습하되, 검증 손실이 지금까지 가장 낮을 때마다 가중치를 복사해 둡니다. 학습 전의 검증 손실과 가중치를 출발점으로 두고, 4절의 반복문에 if 세 줄을 더합니다. 빈칸을 채웁니다.

# ✍️ 빈칸(___)을 채운 뒤 실행하세요
#* torch.manual_seed(42)
#* model = nn.Sequential(
#*     nn.Linear(9, 32), nn.ReLU(),
#*     nn.Linear(32, 16), nn.ReLU(),
#*     nn.Linear(16, 1),
#* )
#* optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
#*
#* best_val = evaluate(model, val_loader, criterion)
#* best_state = copy.deepcopy(model.state_dict())
#* best_epoch = 0
#* for epoch in range(200):
#*     train_one_epoch(model, train_loader, criterion, optimizer)
#*     va = evaluate(model, val_loader, criterion)
#*     if ___:                      # 지금까지보다 낮으면
#*         best_val = ___
#*         best_state = ___         # 가중치 복사
#*         best_epoch = ___
#*
#* print("최적 에폭:", best_epoch, " 그때 검증 손실:", best_val)
#* print("마지막 검증 손실:", evaluate(model, val_loader, criterion))
torch.manual_seed(42)
model = nn.Sequential(
    nn.Linear(9, 32), nn.ReLU(),
    nn.Linear(32, 16), nn.ReLU(),
    nn.Linear(16, 1),
)
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)

best_val = evaluate(model, val_loader, criterion)
best_state = copy.deepcopy(model.state_dict())
best_epoch = 0
for epoch in range(200):
    train_one_epoch(model, train_loader, criterion, optimizer)
    va = evaluate(model, val_loader, criterion)
    if va < best_val:
        best_val = va
        best_state = copy.deepcopy(model.state_dict())
        best_epoch = epoch

print("최적 에폭:", best_epoch, " 그때 검증 손실:", best_val)
print("마지막 검증 손실:", evaluate(model, val_loader, criterion))
최적 에폭: 93  그때 검증 손실: 4.814217567443848
마지막 검증 손실: 6.4644694328308105

💬 결과 해설 — 최적 에폭 93, 그때 검증 손실 약 4.8, 마지막 검증 손실 약 6.5입니다. 가장 좋았던 가중치는 best_state에 있습니다.

되돌립니다.

# ✍️ 직접 입력
model.load_state_dict(best_state)
print(evaluate(model, val_loader, criterion))
4.814217567443848

✅ 체크포인트 — 최적 에폭의 값 4.8로 돌아왔으면 맞습니다. 끝까지 돌리고 가장 좋았던 지점으로 되돌리는 것, 이것이 조기 종료입니다.


6. 테스트 세트는 여기서 한 번

테스트 세트는 지금까지 쓰지 않았습니다. 복원한 모델로 여기서 한 번 평가합니다. RMSE는 MSE에 제곱근을 씌워 연비와 같은 단위로 만든 것입니다.

# ✍️ 직접 입력
test_mse = evaluate(model, test_loader, criterion)
print(test_mse, test_mse ** 0.5)
6.369087219238281 2.5237050578937072

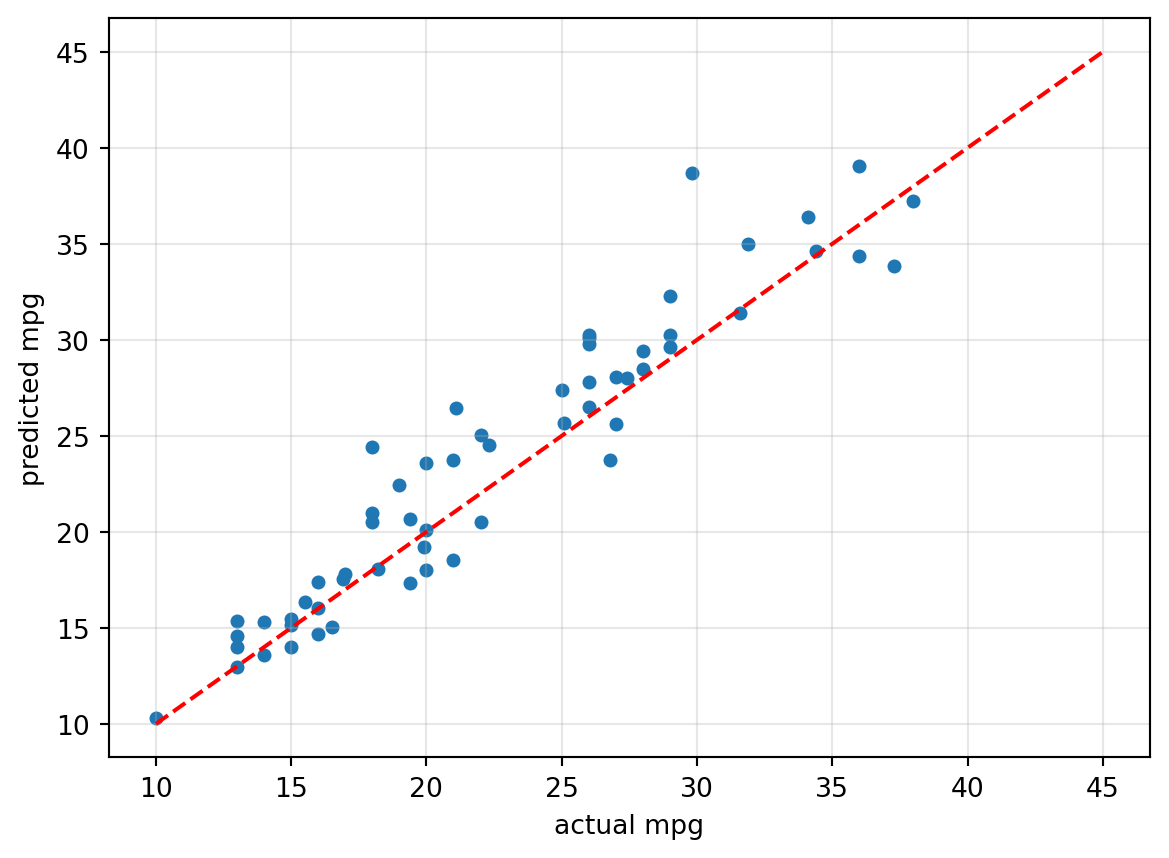
💬 결과 해설 — MSE 약 6.4, RMSE 약 2.5입니다. 새 자동차의 연비를 평균 2.5 mpg 정도 틀립니다.

이 숫자가 좋은 것인지 보려면 기준선이 필요합니다. 모델 없이 훈련 세트의 평균 연비로만 예측하면 얼마나 틀리는지 구합니다.

# ✍️ 직접 입력
baseline_mse = ((y_te - y_tr.mean()) ** 2).mean().item()
print(baseline_mse ** 0.5)
7.118678986661551

💬 결과 해설 — 약 7.1입니다. 모델의 RMSE 2.5는 기준선의 3분의 1 수준입니다.

# ▶ 그대로 실행하세요 — 예측과 실제
model.eval()
with torch.no_grad():
    pred_te = model(X_te)

plt.scatter(y_te, pred_te, s=18)
plt.plot([10, 45], [10, 45], 'r--')
plt.xlabel('actual mpg')
plt.ylabel('predicted mpg')
plt.grid(alpha=0.3)
plt.show()

💬 점이 붉은 대각선에 가까울수록 예측이 정확합니다.


7. 실습 과제 (10분)

📝 과제 1 · 작은 모델은 언제 최적 에폭이 오나

은닉층이 8개뿐인 모델을 5절과 같은 방식으로 학습시켜 최적 에폭과 최적 검증 손실을 출력합니다.

# 📝
#> 힌트: 5절 조립 셀을 그대로 쓰되 model을 nn.Linear(9, 8), nn.ReLU(), nn.Linear(8, 1) 세 층으로 바꿉니다. optimizer도 새 모델로 다시 만듭니다. 복사·복원은 필요 없으니 best_state 줄은 빼도 됩니다.
torch.manual_seed(42)
small = nn.Sequential(nn.Linear(9, 8), nn.ReLU(), nn.Linear(8, 1))
optimizer = torch.optim.Adam(small.parameters(), lr=0.01)

best_val = evaluate(small, val_loader, criterion)
best_epoch = 0
for epoch in range(200):
    train_one_epoch(small, train_loader, criterion, optimizer)
    va = evaluate(small, val_loader, criterion)
    if va < best_val:
        best_val = va
        best_epoch = epoch
print(best_epoch, best_val)
181 6.033134937286377

✏️ 나의 답: 최적 에폭 , 최적 검증 손실

예시 답: 최적 에폭 181, 최적 검증 손실 약 6.0. 파라미터 89개(9×8+8 + 8×1+1)로 기본 모델 865개보다 훨씬 작습니다.

📝 과제 2 · 큰 모델은 어떤가

은닉층이 128개와 64개인 모델로 같은 실험을 합니다. 기본 모델(32, 16)과 비교해 최적 에폭이 언제 오는지 봅니다.

# 📝
#> 힌트: 과제 1과 같되 층을 nn.Linear(9, 128), nn.ReLU(), nn.Linear(128, 64), nn.ReLU(), nn.Linear(64, 1)로 바꿉니다.
torch.manual_seed(42)
big = nn.Sequential(nn.Linear(9, 128), nn.ReLU(), nn.Linear(128, 64), nn.ReLU(), nn.Linear(64, 1))
optimizer = torch.optim.Adam(big.parameters(), lr=0.01)

best_val = evaluate(big, val_loader, criterion)
best_epoch = 0
for epoch in range(200):
    train_one_epoch(big, train_loader, criterion, optimizer)
    va = evaluate(big, val_loader, criterion)
    if va < best_val:
        best_val = va
        best_epoch = epoch
print(best_epoch, best_val)
18 5.569850921630859
모델 파라미터 수 최적 에폭 최적 검증 손실
작은 모델 (8) 89 ✏️ ✏️
기본 모델 (32, 16) 865 93 4.8
큰 모델 (128, 64) 9,601 ✏️ ✏️

예시 답: 최적 에폭 18, 최적 검증 손실 약 5.6. 파라미터 9,601개. 큰 모델은 훈련 데이터를 빨리 외우므로 최적 에폭이 일찍 오고 그 뒤 검증 손실이 오릅니다.

📝 과제 3 · 생각해 보기

6절에서 테스트 RMSE를 본 뒤 “모델을 더 키워서 테스트 RMSE를 낮춰 보자”고 하면 무엇이 문제일까요? 2절의 표와 4-1의 과제 4를 근거로 한두 문장으로 적습니다.

✏️ 나의 답:

예시 답: 테스트 세트를 보고 모델을 고르기 시작하면 테스트 세트도 검증 세트처럼 학습에 쓴 것이 됩니다. 그 점수는 더 이상 새 데이터에 대한 성능이 아닙니다. 모델 크기는 검증 손실로 고르고, 테스트는 마지막에 한 번만 봅니다.


✅ 정리

배운 것 핵심
한 에폭 배치마다 실습 3의 다섯 줄. total / n이 평균 손실 → train_one_epoch
평가 model.eval() + torch.no_grad() 안에서 손실만 → evaluate
러닝커브 훈련·검증 손실을 매 에폭 기록. 검증 손실이 다시 오르면 과적합
조기 종료 검증 손실이 최소일 때 copy.deepcopy(model.state_dict()), 끝나면 load_state_dict
테스트 마지막에 한 번. RMSE 약 2.5(기준선 약 7.1)

다음: 실습 5-1에서는 입력이 표에서 이미지로 바뀝니다. (n, p)였던 입력이 (n, C, H, W)가 될 뿐, 학습 코드는 같습니다.