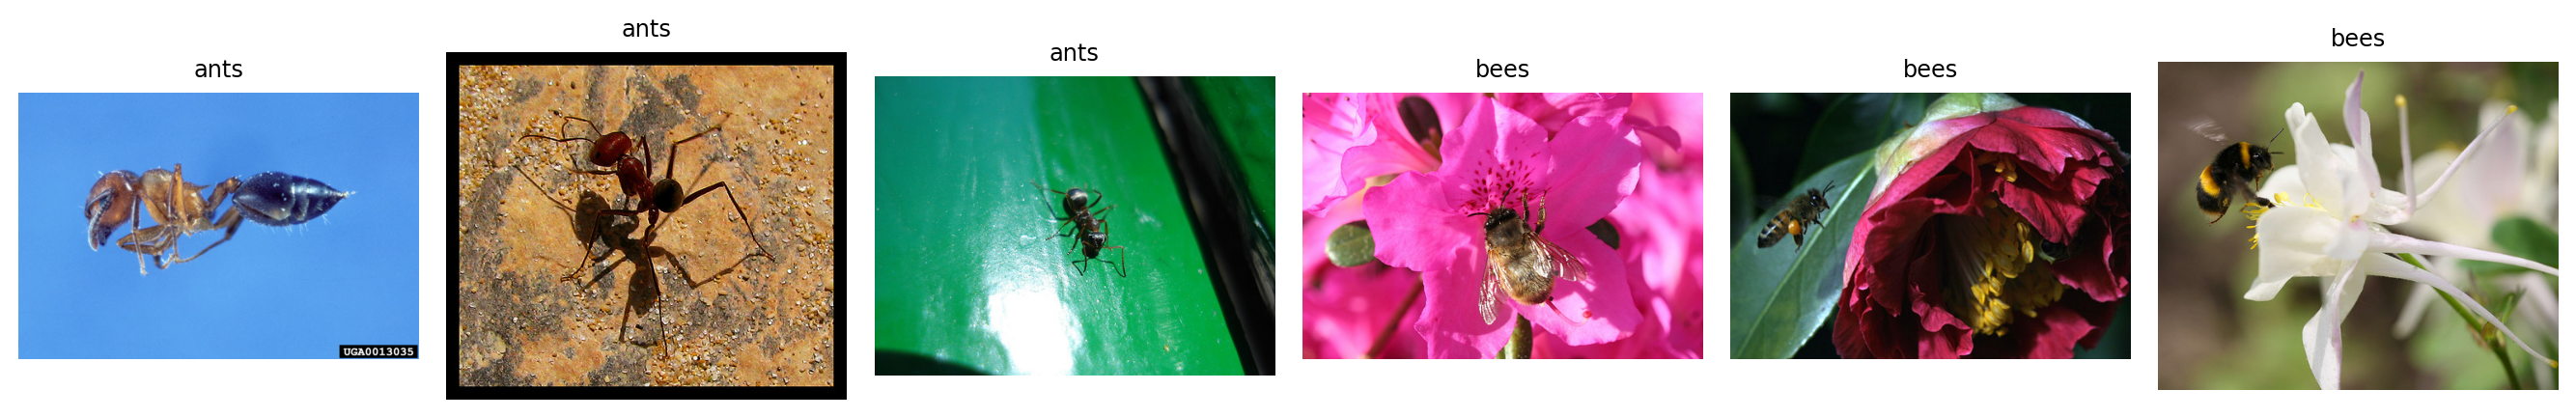
data/
  train/
    ants/   ← 클래스 이름이 곧 폴더 이름
      0013035.jpg ...
    bees/
      ...
  val/
    ants/ ...
    bees/ ...
import os, zipfile, urllib.requestimport numpy as npimport pandas as pdimport torchimport torch.nn as nnimport matplotlib.pyplot as pltfrom torchvision import datasets, transforms, modelsfrom torch.utils.data import DataLoader, Subsettorch.manual_seed(42); np.random.seed(42)ROOT ='../data/hymenoptera_data'ifnot os.path.isdir(ROOT): os.makedirs('../data', exist_ok=True) url ='https://download.pytorch.org/tutorial/hymenoptera_data.zip' urllib.request.urlretrieve(url, '../data/hymenoptera_data.zip')with zipfile.ZipFile('../data/hymenoptera_data.zip') as z: z.extractall('../data')print(sorted(os.listdir(ROOT)))
['train', 'val']
raw = datasets.ImageFolder(ROOT +'/train') # transform 없이 먼저 살펴본다print('클래스 :', raw.classes)print('클래스→번호 :', raw.class_to_idx)print('사진 수 :', len(raw))print('클래스별 장수 :', np.bincount(raw.targets))
클래스        : ['ants', 'bees']
클래스→번호   : {'ants': 0, 'bees': 1}
사진 수       : 244
클래스별 장수 : [123 121]
폴더 이름이 알파벳 순으로 정렬되어 번호가 매겨진다. ants → 0, bees → 1.
for i in [0, 1, 2, 200]: img, lab = raw[i]print(f'{i:3d}{img.size}{raw.classes[lab]}')
  0  (768, 512)  ants
  1  (500, 333)  ants
  2  (500, 282)  ants
200  (500, 364)  bees
크기가 제각각이다. 직접 찍은 사진은 항상 이렇다. 그래서 리사이즈가 필요하다.
직접 해보기 ① — 사진 크기의 분포
raw 의 모든 사진 크기를 조사해 가장 작은 사진과 가장 큰 사진을 찾으시오. 프로젝트에서 직접 찍은 사진도 이렇게 먼저 확인한다.
sizes =None# ← [(w, h), ...] 리스트를 만드세요assert sizes isnotNoneandlen(sizes) ==len(raw)areas = [w * h for w, h in sizes]print('가장 작은 :', sizes[int(np.argmin(areas))])print('가장 큰 :', sizes[int(np.argmax(areas))])
정답 코드 보기
sizes = [raw[i][0].size for i inrange(len(raw))]areas = [w * h for w, h in sizes]print('가장 작은 :', sizes[int(np.argmin(areas))])print('가장 큰 :', sizes[int(np.argmax(areas))])print('평균 가로x세로:', round(np.mean([s[0] for s in sizes])), 'x',round(np.mean([s[1] for s in sizes])))
가장 작은 : (193, 130)
가장 큰   : (1488, 1984)
평균 가로x세로: 484 x 385
resnet = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)def n_params(m, only_trainable=False): ps = m.parameters()returnsum(p.numel() for p in ps if (p.requires_grad ornot only_trainable))print('전체 파라미터 :', f'{n_params(resnet):,}')print('마지막 층 :', resnet.fc)print('특성 벡터 길이:', resnet.fc.in_features)
전체 파라미터 : 11,689,512
마지막 층     : Linear(in_features=512, out_features=1000, bias=True)
특성 벡터 길이: 512
fc 바로 앞이 GAP이다. Ch07에서 본 그대로 — 마지막 특성 맵을 채널마다 평균 하나로 줄여 512개의 숫자로 만든 뒤, 그것을 1000개 클래스로 분류한다.
h = torch.zeros(1, 3, 224, 224)for name, layer inlist(resnet.named_children()): h = layer(h) if name !='fc'else layer(h.flatten(1))print(f'{name:9s} → {tuple(h.shape[1:])}')
def build_frozen(n_classes=2): m = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)for p in m.parameters(): p.requires_grad =False# 전부 얼린다 m.fc = nn.Linear(m.fc.in_features, n_classes) # 새로 만든 층은 requires_grad=Truereturn mfrozen = build_frozen()total =sum(p.numel() for p in frozen.parameters())trainable =sum(p.numel() for p in frozen.parameters() if p.requires_grad)print('전체 파라미터 :', f'{total:,}')print('학습되는 파라미터:', f'{trainable:,}')print('공식 512*2+2 :', 512*2+2)print('비율 :', f'{100*trainable/total:.4f}%')
전체 파라미터   : 11,177,538
학습되는 파라미터: 1,026
공식 512*2+2    : 1026
비율            : 0.0092%
6-2. Ch08의 손계산을 코드로 — ResNet-50, 7클래스
r50 = models.resnet50(weights=None) # 가중치는 필요 없다, 구조만 센다total50 =sum(p.numel() for p in r50.parameters())head =2048*7+7print('ResNet-50 전체 :', f'{total50:,}')print('새 분류기 :', f'{head:,}', ' = 2048*7+7')print('비율 :', f'{100*head/total50:.3f}%')
ResNet-50 전체 : 25,557,032
새 분류기      : 14,343  = 2048*7+7
비율           : 0.056%
이론에서 손으로 구한 14,343개, 0.06% 미만과 같다.
직접 해보기 ② — 클래스 수를 바꾸면
프로젝트는 클래스가 3~5개다. ResNet-18을 동결하고 클래스 4개로 분류할 때 학습되는 파라미터 수를 먼저 계산한 뒤 확인하시오.
my_answer =None# ← 예상 파라미터 수m4 = build_frozen(n_classes=4)real =sum(p.numel() for p in m4.parameters() if p.requires_grad)assert my_answer == real, f'다릅니다. 실제 {real} — 공식은 512 x 클래스수 + 클래스수'print('통과', real)
정답 코드 보기
my_answer =512*4+4m4 = build_frozen(n_classes=4)real =sum(p.numel() for p in m4.parameters() if p.requires_grad)print('공식 512x4+4 =', my_answer, ' 실제 =', real)
공식 512x4+4 = 2052 실제 = 2052
6-3. 층별로 얼마나 얼었는지 확인
rows = []for name, module in frozen.named_children(): tot =sum(p.numel() for p in module.parameters()) tra =sum(p.numel() for p in module.parameters() if p.requires_grad)if tot >0: rows.append({'블록': name, '파라미터': f'{tot:,}', '학습 대상': f'{tra:,}'})print(pd.DataFrame(rows).to_string(index=False))
    블록      파라미터 학습 대상
 conv1     9,408     0
   bn1       128     0
layer1   147,968     0
layer2   525,568     0
layer3 2,099,712     0
layer4 8,393,728     0
    fc     1,026 1,026
7. 세 가지 전략을 비교한다
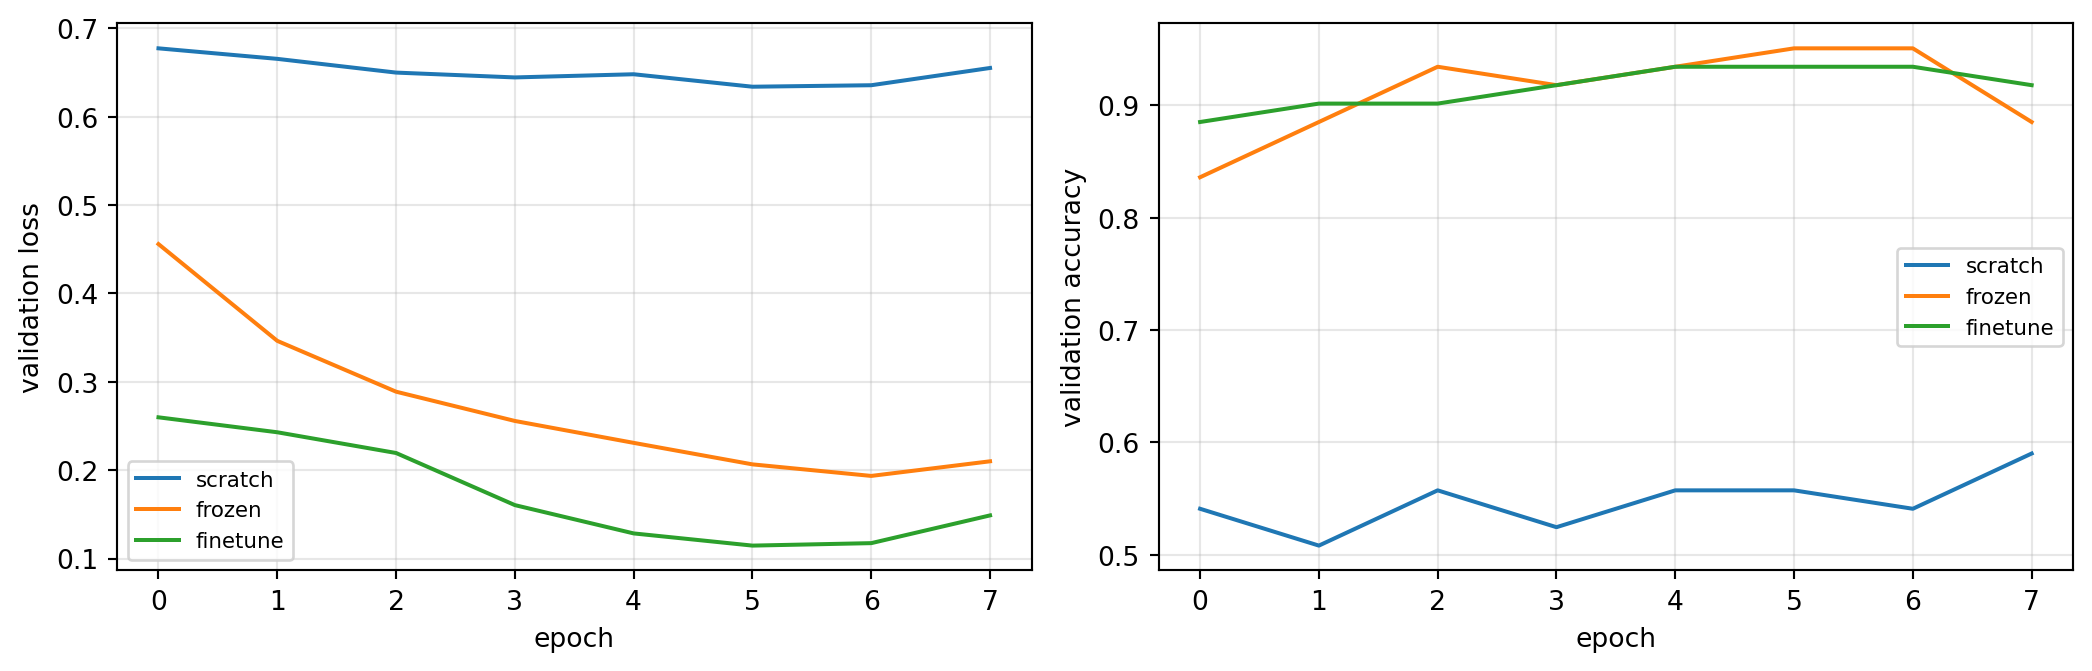
같은 데이터, 같은 학습 루프, 모델만 바꾼다.
import copy, timedef run_epoch(model, loader, criterion, optimizer=None): train_mode = optimizer isnotNone model.train() if train_mode else model.eval() total, correct, n =0.0, 0, 0with torch.set_grad_enabled(train_mode):for xb, yb in loader: xb, yb = xb.to(device), yb.to(device) logits = model(xb) loss = criterion(logits, yb)if train_mode: optimizer.zero_grad(); loss.backward(); optimizer.step() total += loss.item() *len(yb) correct += (logits.argmax(1) == yb).sum().item() n +=len(yb)return total / n, correct / ndef fit(model, loaders, lr, epochs=8, tag=''): tr_loader, va_loader, _ = loaders model = model.to(device) criterion = nn.CrossEntropyLoss() params = [p for p in model.parameters() if p.requires_grad] optimizer = torch.optim.Adam(params, lr=lr) hist = {'tr': [], 'va': [], 'va_acc': []} best = (float('inf'), None, 0) t0 = time.time()for ep inrange(epochs): trl, _ = run_epoch(model, tr_loader, criterion, optimizer) val, vaa = run_epoch(model, va_loader, criterion) hist['tr'].append(trl); hist['va'].append(val); hist['va_acc'].append(vaa)if val < best[0]: best = (val, copy.deepcopy(model.state_dict()), ep) model.load_state_dict(best[1])print(f'{tag:24s} best epoch {best[2]:2d} val acc {hist["va_acc"][best[2]]:.4f} 'f'({time.time()-t0:.0f}s, 학습 파라미터 {sum(p.numel() for p in params):,})')return model, hist, best[2]
Adam([p for p in m.parameters() if p.requires_grad], lr)
특성만 뽑기
m.fc = nn.Identity() + @torch.no_grad()
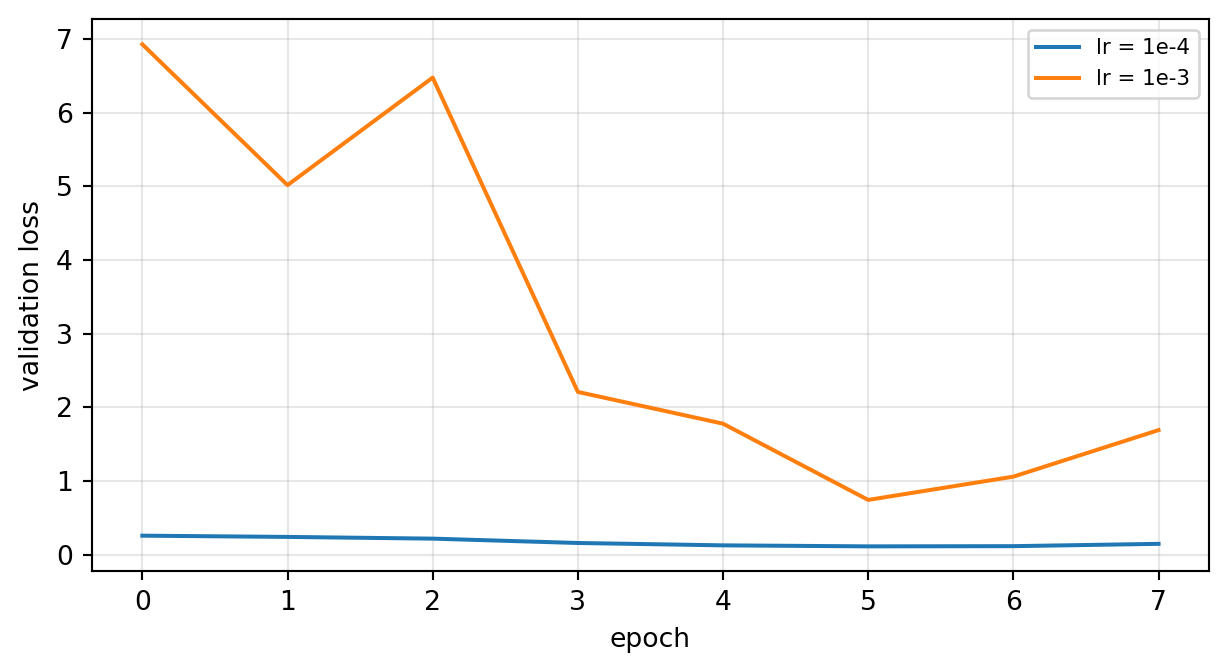
미세조정 학습률
처음부터 학습할 때의 \(1/10 \sim 1/100\)
전략 선택 기준 (Ch08)
상황
전략
내 사진 수백 장
동결 — 과적합 위험 최소
수만 장 이상, 사전학습 도메인과 다름
전체 미세조정 (작은 학습률)
프로젝트는 클래스당 80장 내외로 시작한다. 표의 첫 줄에 해당한다 — 동결이 기본값이다.
스스로 확인해 보기
아래 결과를 먼저 예상한 뒤 실행해서 대조한다.
m = models.resnet18(weights=None)print('원래 fc :', m.fc)for p in m.parameters(): p.requires_grad =Falsem.fc = nn.Linear(512, 5)total =sum(p.numel() for p in m.parameters())train =sum(p.numel() for p in m.parameters() if p.requires_grad)print('\n전체 :', f'{total:,}')print('학습 대상:', f'{train:,}', ' (= 512*5+5 =', 512*5+5, ')')print('비율 :', f'{100*train/total:.4f}%')# 분류기에 은닉층을 하나 넣으면?m.fc = nn.Sequential(nn.Linear(512, 128), nn.ReLU(), nn.Linear(128, 5))train2 =sum(p.numel() for p in m.parameters() if p.requires_grad)print('\n은닉층 추가 시 학습 대상:', f'{train2:,}', f' ({train2/train:.1f}배)')
원래 fc : Linear(in_features=512, out_features=1000, bias=True)

전체     : 11,179,077
학습 대상: 2,565  (= 512*5+5 = 2565 )
비율     : 0.0229%

은닉층 추가 시 학습 대상: 66,309  (25.9배)